Главная
» Технология
»
Что вызывает массовые простои облачных платформ? Закономерности сбоев, лежащие в основе крупных отключений.
Что вызывает массовые простои облачных платформ? Закономерности сбоев, лежащие в основе крупных отключений.
Массовые простои облачных платформ редко возникают из-за простого «отключения» одного сервера. Наиболее серьезные инциденты обычно начинаются с одной технической неисправности — неправильной конфигурации, дефекта программного обеспечения, проблемы с DNS, сбоя сети или события в инфраструктуре — а затем распространяются, поскольку многие сервисы зависят от одних и тех же управляющих плоскостей, баз данных, систем идентификации, балансировщиков нагрузки или региональных ресурсов.
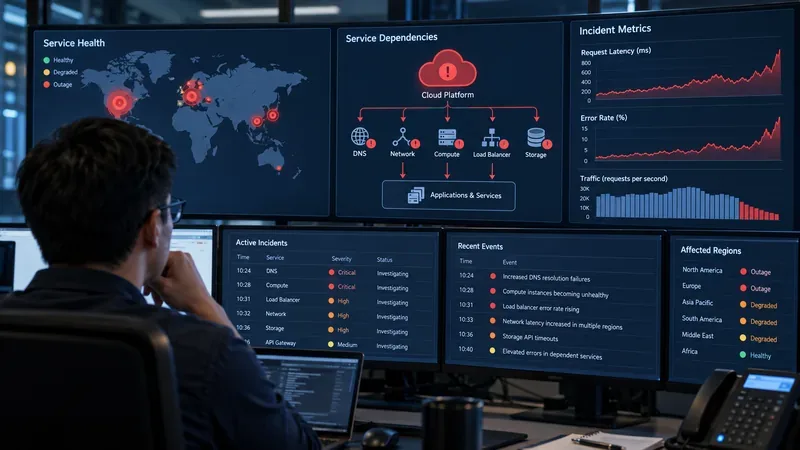
Показательный сценарий: представьте себе вымышленного облачного провайдера под названием Northstar Cloud. В 10:05 утра в региональном сервисе автоматически вносятся изменения в сетевые настройки. В течение нескольких минут клиенты начинают сообщать о сбоях API-запросов. В 10:12 прекращается запуск новых виртуальных машин. В 10:20 балансировщики нагрузки начинают помечать работоспособные бэкэнды как недоступные. К 10:35 десятки, на первый взгляд, несвязанных между собой продуктов выходят из строя. Этот сценарий является гипотетическим, а не описанием реального сбоя. Он полезен, потому что показывает, почему небольшая первоначальная ошибка может перерасти в крупное событие на платформе.
Командам, занимающимся эксплуатацией облачных сервисов, часто приходится отслеживать сбой, начиная с первой вышедшей из строя зависимости и заканчивая DNS, сетью, вычислительными ресурсами, балансировкой нагрузки, хранилищем и нижестоящими приложениями.
Краткий ответ: крупные сбои в облачных сервисах обычно представляют собой каскадные отказы.
Основными причинами масштабных простоев облачных платформ являются ошибки конфигурации и развертывания, скрытые программные дефекты, сбои DNS и маршрутизации, зависимости между общими сервисами, исчерпание пропускной способности во время сбоя или восстановления, проблемы в плоскости управления и физические сбои, затрагивающие центр обработки данных или зону доступности. Масштаб сбоя зависит не столько от первой ошибки, сколько от того, насколько широко используется затронутый компонент.
Полезный пример из реальной жизни приводит AWS. В своем официальном отчете о сбое в работе сервиса DynamoDB в Северной Вирджинии в октябре 2025 года AWS сообщила, что скрытая проблема гонки в автоматизированной системе управления DNS DynamoDB привела к созданию некорректной пустой DNS-записи для региональной конечной точки. Этот сбой DNS затронул клиентов и внутренние сервисы AWS, зависящие от DynamoDB, а последующие работы по восстановлению привели к проблемам с запуском EC2 и сетевыми балансировщиками нагрузки. Инцидент задокументирован в отчете AWS о сбое в работе DynamoDB в октябре 2025 года .
1. Изменения конфигурации могут привести к неожиданно большому радиусу взрыва.
Ошибки конфигурации являются одними из наиболее распространенных явлений при крупных инцидентах в распределенных системах, поскольку современные платформы управляются автоматизированным способом. Одно изменение может быть применено к тысячам хостов, маршрутизаторов, DNS-записей или конечных точек служб быстрее, чем это мог бы сделать оператор вручную.
Вернемся к сценарию с облаком Northstar. Предположим, что изменение сетевых настроек в 10:05 предназначалось для десяти машин, но было применено к нескольким регионам. Это изменение не обязательно должно приводить к поломке оборудования. Оно может просто уменьшить доступную сетевую пропускную способность, изменить маршрутизацию или привести к тому, что системы начнут отклонять трафик, который в противном случае был бы работоспособным. Как только общая пропускная способность упадет ниже требуемой, клиенты столкнутся с таймаутами и повторными попытками, что создаст еще большую нагрузку.
В своем официальном отчете о сбое 2019 года Google описал аналогичный механизм: изменение конфигурации, предназначенное для небольшого числа серверов в одном регионе, было некорректно применено гораздо шире, в результате чего в нескольких регионах перестало использоваться более половины доступной сетевой мощности. Затем трафик перегрузил оставшуюся мощность. См. официальное сообщение Google о сбое в работе сервиса в 2019 году .
Именно поэтому опытные операторы облачных сервисов используют поэтапное развертывание, проверку, автоматический откат, ограничения скорости изменений и контроль «радиуса поражения». Эти меры защиты не исключают инцидентов, но могут предотвратить превращение одного неудачного изменения в событие, затрагивающее всю платформу.
2. Программные дефекты могут оставаться скрытыми до тех пор, пока не возникнут редкие временные условия.
Крупные облачные платформы управляют огромными парками распределенного программного обеспечения. Некоторые дефекты остаются незамеченными в течение месяцев или лет, поскольку требуют редкой последовательности событий: обновления одного и того же состояния двумя контроллерами, необычной задержки, устаревших метаданных или одновременного запуска процесса восстановления и процесса очистки.
В вымышленном инциденте с компанией Northstar представьте, что два независимых автоматизированных процесса обновляют один и тот же DNS-план. Один из них задерживается, другой завершает более новое обновление, а затем процедура очистки удаляет данные, которые только что активировал задержанный процесс. Каждый отдельный компонент может казаться работающим как положено, но их взаимодействие создает недопустимое состояние.
Событие AWS DynamoDB 2025 года наглядно иллюстрирует эту категорию. AWS объяснила сбой, приведший к возникновению проблемы, скрытым состоянием гонки между резервными компонентами управления DNS. Значение этого явления выходит за рамки одного поставщика: резервирование повышает надежность только тогда, когда резервные компоненты не могут повредить общее состояние из-за одной и той же логики или ошибки синхронизации.
3. Сбои DNS и сети могут сделать работоспособные системы недоступными.
Сервис может быть полностью активирован, но при этом оставаться фактически недоступным, если клиенты не могут разрешить его имя хоста или пакеты данных не достигают его. Поэтому DNS, маршрутизация, балансировка нагрузки и сетевая конфигурация находятся на критическом пути практически для любого облачного продукта.
В нашем примере с Northstar клиенты могут предположить, что сам вычислительный сервис вышел из строя из-за истечения времени ожидания вызовов API. Но фактические вычислительные серверы могут быть работоспособны, в то время как DNS не возвращает ни одной доступной конечной точки, отсутствует маршрут или балансировщик нагрузки удалил работоспособные целевые серверы.
AWS неоднократно документировала подобный сбой. В инциденте 2018 года в регионе Сеула AWS сообщила, что обновление конфигурации ошибочно удалило параметр, определяющий минимальное количество работоспособных хостов для парка DNS-серверов EC2. Снижение мощности DNS-серверов привело к сбоям DNS-запросов от экземпляров EC2. Подробности приведены в сводке AWS по проблеме разрешения DNS-запросов EC2 в Сеуле в 2018 году .
Сбои в сети также быстро усугубляются, поскольку приложения повторяют неудачные попытки подключения. Агрессивное поведение при повторных попытках может превратить частичное нарушение работы сети в гораздо больший всплеск трафика.
4. Общие зависимости приводят к одновременному сбою несвязанных между собой сервисов.
Облачные сервисы не являются изолированными продуктами. Управляемая база данных может зависеть от служб идентификации, внутренней DNS, хранилища, сети, систем планирования, служб сертификатов и телеметрии. Бессерверная платформа может зависеть от вычислительных мощностей, сети, очередей и баз данных плоскости управления. Если одна общая зависимость выходит из строя, многие продукты могут одновременно начать давать сбои.
Это объясняет один из самых запутанных симптомов сбоев: клиенты видят ошибки в нескольких сервисах и предполагают, что произошло несколько независимых сбоев. В действительности же видимые сбои могут иметь одну и ту же причину на более высоком уровне.
В сценарии Northstar сервис виртуальных машин, сервис контейнеров и бессерверный сервис могут начать давать сбои, поскольку они используют одну и ту же внутреннюю базу данных ресурсов. Продукты, используемые клиентами, разные, но зависимости между ними — нет.
Инцидент в AWS в октябре 2025 года продемонстрировал подобную каскадную реакцию, когда внутренние сервисы, использующие DynamoDB, пострадали от первоначальной проблемы с DNS, за которой последовали последствия восстановления для EC2, Network Load Balancer, Lambda, контейнерных сервисов, функций, связанных с идентификацией, и других продуктов.
5. Восстановление может завершиться неудачей, поскольку объем невыполненных задач превышает нормальную рабочую нагрузку.
Восстановление исходного неисправного компонента не всегда завершает сбой. Во время простоя очереди растут, срок действия аренды истекает, проверки работоспособности завершаются неудачей, автомасштабировщики запрашивают резервные мощности, клиенты повторяют запросы, и накапливаются обновления конфигурации. Когда неисправная зависимость возвращается, все ожидающие системы могут попытаться восстановиться одновременно.
В примере с Northstar предположим, что DNS-сервер восстанавливается в 10:45. Тысячи вычислительных хостов теперь пытаются продлить истекшие аренды. В то же время клиенты повторяют неудачные развертывания, а системы автомасштабирования запрашивают замену экземпляров. Плоскость управления внезапно начинает обрабатывать в несколько раз больше обычной нагрузки. Если у нее нет эффективных ограничений скорости или приоритезации восстановления, она может перейти во второй режим отказа, даже если первоначальная ошибка устранена.
AWS описала аналогичную проблему восстановления в 2025 году: после восстановления доступа к DynamoDB подсистеме EC2 пришлось заново устанавливать большое количество арендных соглашений. Обработка накопившегося объема данных стала затруднительной до наступления таймаутов, и AWS заявила, что подсистема перешла в состояние «коллапса перегрузки». Эта деталь важна, поскольку она показывает, почему продолжительность сбоя может быть намного больше, чем время, необходимое для устранения первоначальной причины.
6. Проверки состояния и автоматическое переключение на резервный сервер иногда могут приводить к потере работоспособности оборудования.
Проверки состояния сети необходимы, но они также являются автоматизированными системами принятия решений. Если сеть работает медленно или передача состояния задерживается, система проверки состояния может прийти к выводу, что исправные ресурсы неисправны, и вывести их из эксплуатации. Это может еще больше снизить пропускную способность, создавая замкнутый цикл обратной связи.
В вымышленном сценарии балансировщики нагрузки Northstar начинают проверять вновь запущенные экземпляры до того, как конфигурация сети полностью распространится. Проверки завершаются неудачей, работоспособные экземпляры отключаются, трафик перенаправляется на меньшее количество оставшихся узлов, и эти узлы перегружаются.
Подобная закономерность также наблюдалась во время мероприятия AWS 2025. AWS сообщила, что проверки работоспособности Network Load Balancer иногда завершались с ошибкой, пока состояние сети для новых экземпляров еще передавалось, что приводило к выводу ресурсов из эксплуатации. Это напоминание о том, что логика переключения на резервный сервер должна быть ограничена по скорости и тестироваться при частичном сбое, а не только в условиях «здорового/нездорового» состояния.
7. Сохраняется вероятность сбоев в работе центров обработки данных, электропитания, систем охлаждения и зон доступности.
Не все сбои начинаются с программного обеспечения. Могут выйти из строя электропитание, системы охлаждения, оптоволокно, сетевое оборудование и другая физическая инфраструктура. Облачная архитектура разработана с учетом этой реальности, поэтому крупные провайдеры делят регионы на изолированные зоны.
Microsoft поясняет, что зоны доступности Azure — это отдельные группы центров обработки данных с независимым электропитанием, охлаждением и сетевым оборудованием. Microsoft также отмечает, что развертывание в зонах не гарантирует сохранение работоспособности после сбоя в работе зоны; клиентам необходимо использовать несколько зон или резервные службы зон там, где это поддерживается. См. официальный обзор зон доступности Azure от Microsoft .
На практике облачный провайдер может сделать зону независимой, но рабочая нагрузка клиента может по-прежнему иметь базу данных одной зоны, зависимость от одного регионального управления или процесс переключения на резервный сервер, который никогда не использовался.
Почему сбой в облачной среде может выглядеть глобальным, даже если его первопричина носит региональный характер.
«Глобальный сбой» часто описывает влияние на клиентов, а не физическое местоположение вышедшего из строя оборудования. Региональный сервис может поддерживать аутентификацию, DNS, метаданные, конвейеры сборки, панели мониторинга или API управления, используемые из других регионов. Поэтому приложения по всему миру могут выйти из строя, поскольку они зависят от сервиса, сосредоточенного в одном месте.
Это различие имеет значение при диагностике инцидента. Инженеры должны задавать два разных вопроса: Где произошла первая ошибка? и Какие зависимости позволили этой ошибке распространиться? Ответы на эти вопросы часто различаются.
Как определить вероятную причину во время инцидента в режиме реального времени
Для операторов наиболее быстрый путь — это сопоставление симптомов, а не исследование каждого продукта по отдельности. Если множество сервисов выходят из строя одновременно, ищите общую зависимость. Если существующие рабочие нагрузки остаются работоспособными, в то время как новые развертывания дают сбой, подозревайте проблему на уровне управления, планирования, мощности или предоставления ресурсов. Если IP-соединение работает, но имена сервисов не работают, исследуйте DNS. Если после объявления о восстановлении увеличивается количество ошибок, ищите штормы повторных попыток, задержки, истекшие аренды, циклы обратной связи проверок работоспособности или недостаточную мощность восстановления.
Системы контроля состояния провайдера также могут помочь отличить инцидент на платформе от ошибки, специфичной для приложения. Например, Google Cloud публикует текущие и исторические инциденты через свою официальную панель мониторинга состояния сервисов , а AWS публикует сводки о важных событиях через свои официальные сводки после событий .
Что могут сделать клиенты, чтобы уменьшить негативное воздействие
Ни одна архитектура не может гарантировать полное отсутствие простоев, но ряд проектных решений снижает риски. Используйте несколько зон доступности для производственных нагрузок, если сервис это поддерживает. Для нагрузок, которые не могут выдержать региональный сбой, оцените многорегиональные решения и поймите компромиссы между согласованностью данных и безопасностью. Устраните скрытые точки отказа, такие как одна региональная служба идентификации, один путь DNS или один административный API, от которых зависит каждое действие по восстановлению.
Приложения также должны корректно завершать работу при сбоях. Это может означать предоставление кэшированного контента, постановку в очередь некритических операций записи, ограничение повторных попыток с экспоненциальной задержкой и дрожанием, разделение операций плоскости управления и трафика плоскости данных, а также сохранение сокращенного режима «только для чтения» или «основной транзакции» во время частичных сбоев. Процедуры восстановления следует тестировать в условиях перегрузки, поскольку перезапуск зависимости в пустой тестовой среде сильно отличается от восстановления зависимости, когда миллионы запросов ожидают.
Главный урок, извлеченный из масштабных простоев облачных сервисов.
Вернемся к сценарию с облаком Northstar. Изменение конфигурации в 10:05 может быть причиной, но это не полное объяснение. Сбой становится масштабным, потому что сеть используется совместно, в автоматизированных системах обнаружен дефект синхронизации, нижестоящие сервисы зависят от одного и того же состояния, проверки работоспособности расходуют ресурсы, повторные попытки увеличивают нагрузку, а системам восстановления приходится обрабатывать огромный объем невыполненных задач.
Это основная закономерность, лежащая в основе многих крупных инцидентов в облачной среде: инициирующий сбой часто незначителен по сравнению с цепочкой зависимостей, которая его усиливает. Поэтому понимание простоев в облачной среде означает изучение как первопричины, так и распространения проблемы. Наиболее отказоустойчивые решения предполагают, что отдельные компоненты будут выходить из строя, и фокусируются на предотвращении превращения этих сбоев в события, затрагивающие всю систему.