Главная
» Технология
»
Сбой в работе Salesforce в 2025 году: ретроспектива основных сбоев
Сбой в работе Salesforce в 2025 году: ретроспектива основных сбоев
Самый важный вывод из анализа сбоев Salesforce за 2025 год заключается в том, что не было единого, определяющего год «глобального сбоя Salesforce». Вместо этого клиенты столкнулись с несколькими различными моделями сбоев: масштабный сбой в работе сервиса в феврале, сбои аутентификации в нескольких облачных средах в июне, крупный инцидент на платформе Heroku, вызванный непреднамеренным обновлением от поставщика, сбой в сети центра обработки данных в Индианаполисе, а также более поздние инциденты, ограниченные отдельными экземплярами или функциями. Это различие имеет значение, поскольку правильная реакция зависит от того, что именно вышло из строя.
Если пользователи не могут войти в систему, обновление страницы в браузере не решит проблему. Если отображение общедоступной страницы состояния задерживается, общий мониторинг сбоев также может быть неполным. Если Salesforce доступен, но очередь интеграции зависла, сама CRM может выглядеть работоспособной, в то время как бизнес-процессы по-прежнему дают сбои. Практический урок 2025 года заключается в том, чтобы сочетать уведомления о состоянии для каждого клиента, независимый мониторинг, проверенные ручные процедуры и проверку восстановления для нижестоящих систем.
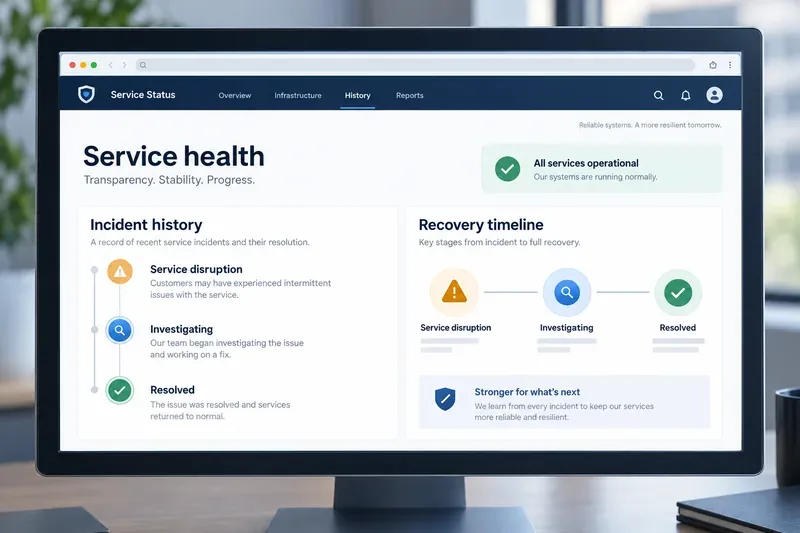
На типовой панели мониторинга состояния сервиса отображаются этапы, которые команды рассматривают при восстановлении хронологии сбоя; это концептуальная иллюстрация, а не снимок экрана Salesforce в реальном времени.
Какие основные изменения произошли в Salesforce в 2025 году?
Приведенные ниже инциденты полезны для ретроспективного анализа, поскольку демонстрируют различные режимы отказов. Это не означает, что здесь перечислены все события состояния Salesforce за 2025 год.
Дата
Нарушение
Что показывают записи
Почему это важно
7 февраля
Сбой в работе сервиса
Согласно официальным данным о происшествии, сбой завершился в 11:21 UTC и продолжался около 2 часов 20 минут.
Масштабное событие в работе сервиса может повлиять на нормальную работу Salesforce, даже если его первопричина не разглашается публично.
10 июня
Сбои аутентификации между облачными средами
Компания Salesforce сообщила о влиянии на работу служб аутентификации для Heroku, Commerce, Marketing Cloud и сервисов Salesforce.
Зависимости между данными для входа в систему и идентификацией могут привести к сбоям в работе разных продуктов, даже если техническая неисправность затрагивает не все продукты.
10 июня
Платформа Heroku подорвала позиции Heroku.
Позже Heroku объяснила инцидент непреднамеренным обновлением системы, примененным к производственной инфраструктуре поставщиком. Это также затронуло сайт состояния Heroku.
Канал связи может стать частью инцидента, что делает необходимым наличие независимых каналов оповещения.
18 июня
Сбой в работе сети центров обработки данных в Индианаполисе
Компания Salesforce сообщила, что сбой в системе охлаждения в центре обработки данных в Индианаполисе затронул блоки 1 и 6.
Аварии на физической инфраструктуре могут быть менее масштабными, чем глобальные сбои, но всё же серьёзными для отдельных случаев.
1 ноября
Нарушение работы основных сервисов на уровне экземпляра
В официальном журнале инцидентов указано, что IND76 является затронутым случаем, и событие отмечено как завершенное.
Проверки, специфичные для конкретного экземпляра, более полезны, чем полагаться только на общие отчеты типа «Не работает Salesforce?».
31 декабря
Снижение производительности мессенджера WhatsApp
Компания Salesforce сообщила о снижении производительности функции обмена сообщениями WhatsApp в нескольких случаях, а позже подтвердила восстановление в 16:56 UTC.
Одна из функций может быть недоступна, в то время как остальная часть CRM-системы остается работоспособной.
Инциденты 10 июня выявили два разных уровня сбоев.
10 июня особенно важно, потому что «сбой в работе Salesforce» может описывать не одно событие. В записи Trust Record компании Salesforce описывались сбои многофакторной аутентификации, затронувшие несколько облачных платформ. В более позднем отчете Heroku о корректирующих действиях описывался сбой в работе платформы, начавшийся в 06:00 UTC и вызванный непреднамеренным обновлением системы, примененным к производственной инфраструктуре поставщиком.
Компания Heroku также признала, что ее сайт состояния был затронут. Согласно обновлению Heroku о корректирующих действиях , недостатки в дизайне страницы состояния и задержка API привели к таймаутам, и на странице могло отображаться отсутствие активных инцидентов. Heroku заявила, что в ответ приняла меры, включающие в себя постоянную приостановку автоматических обновлений операционных систем провайдера, аудит образов, дополнительный мониторинг, кэширование содержимого страницы состояния, независимое планирование коммуникаций и более строгие процедуры реагирования на инциденты.
Это важное различие для администраторов. Страница состояния — это не сама служба, а пользователи, которые используют её, чтобы решить, следует ли ждать, переключиться на резервный сервер, открыть заявку в службу поддержки или связаться со своими пользователями. Если канал состояния использует слишком много общей инфраструктуры с соответствующей платформой, он может не предоставлять надёжную информацию в тот момент, когда она наиболее необходима.
Чему научил клиентов Salesforce рекорд 2025 года?
1. Аутентификация заслуживает отдельного плана обеспечения непрерывности работы.
Команда может иметь исправные данные приложения, но при этом оказаться не в состоянии работать, если не удастся войти в систему, пройти многофакторную аутентификацию или установить связь с системой. Это особенно важно для компаний, использующих Salesforce, Heroku, Commerce и Marketing Cloud одновременно. Необходимо задокументировать, каким пользователям необходим доступ к каким системам, определить контактные лица на случай чрезвычайных ситуаций, которые могут получать обновления от поставщика, и определить, какая работа может продолжаться без успешного входа в систему.
Для небольшой команды продаж это может означать кратковременный ручной список звонков и общий журнал инцидентов. Для контакт-центра или медицинского учреждения это может потребовать формальной процедуры на случай простоя, утвержденного экспорта данных только для чтения и проверенной схемы эскалации. Масштаб резервного варианта должен соответствовать бизнес-последствиям блокировки доступа.
2. Одной стандартной страницы состояния недостаточно.
В собственной документации Salesforce поясняется, что функция «Статус доверия» предоставляет информацию о доступности и производительности, в то время как более новые представления «Мой центр доверия» разработаны с учетом потребностей арендаторов и поддерживаемых продуктов. Суть проста: необходимо знать идентификатор вашего экземпляра или арендатора до начала инцидента.
Salesforce также предоставляет инструкции по подписке на сообщения и уведомления My Trust Center . Настройте уведомления для тех, кому необходимо выполнить необходимые действия, а не только для администратора, первоначально создавшего организацию. Сохраните независимый канал связи, например, внутреннюю страницу состояния или утвержденную группу обмена сообщениями, чтобы ваша компания могла общаться, даже если сайт состояния поставщика работает медленно или недоступен.
3. Восстановление — это не просто просмотр экрана входа в систему.
Когда Salesforce сообщает о восстановлении работы сервисов, инцидент всё ещё может иметь последствия для бизнеса. Задержка запроса к API может привести к двукратной повторной попытке отправки, задержка доставки сообщения в очередь или сбой развертывания могут привести к рассинхронизации записей. После восстановления проверьте наиболее важные рабочие процессы: аутентификацию, вызовы API, запланированные задания, очереди интеграции, доставку электронной почты или сообщений, создание записей и актуальность отчётов.
Например, представьте себе команду поддержки среднего размера, агенты которой используют обращения в Salesforce, а отдельная система электронной коммерции отправляет обновления через интеграцию. Если Salesforce становится доступен в 10:00 утра, но в очереди интеграции содержатся сообщения о сбоях, произошедших во время сбоя, команда не должна закрывать инцидент только потому, что браузер загрузился. Правильный тест заключается в том, проходят ли новые и ранее не завершившиеся обновления обращений через весь рабочий процесс без дублирования.
Какие меры по обеспечению непрерывности деятельности подходят для вашей организации?
деловое состояние
Практический минимум
Когда добавить больше
Небольшая команда; небольшой перерыв допустим.
Подпишитесь на соответствующие уведомления Trust, запишите идентификатор экземпляра и ведите краткий контрольный список для выполнения ручной работы.
Добавьте тесты на экспорт и восстановление, если история взаимодействия с клиентами или данные о соответствии требованиям имеют решающее значение.
Доходы, работа контакт-центра или сервисного центра полностью зависят от Salesforce.
Используйте независимый мониторинг, процедуру обработки простоев, средства контроля повторных попыток интеграции и назначенного ответственного за инцидент.
Перед реальным сбоем проверьте работоспособность резервных или альтернативных каналов приема данных в рабочее время.
Salesforce интегрирован с Heroku или несколькими облачными платформами.
Отслеживайте источник состояния каждого продукта и документируйте зависимости аутентификации отдельно.
Проведите совместные учения по восстановлению, проверяющие одновременно вход в систему, API, очереди и взаимодействие с клиентами.
Регулируемые или ценные данные
Используйте утвержденную схему резервного копирования и хранения данных, средства контроля доступа, журналы аудита и руководство по восстановлению.
Необходимо, чтобы руководство по эксплуатации было рассмотрено специалистами по безопасности, юристами, специалистами по соблюдению нормативных требований и владельцами бизнеса.
Как использовать этот ретроспективный анализ в 2026 году и в последующие годы
Начните с карты зависимостей на одной странице. Запишите ваш экземпляр или клиент Salesforce, поставщика идентификации, подключенные облака, критически важные интеграции, подписки на статусы и ручной процесс, используемый во время сбоя. Затем определите объективную проверку восстановления для каждого важного рабочего процесса. «Salesforce вернулся» — слишком расплывчато; «новые обращения, исходящие сообщения и обновления заказов обрабатываются без дубликатов» — это можно проверить.
Наконец, следует рассмотреть изменения, которые могут повлиять на доступность: обновления от поставщиков, изменения операционной системы, релизы, изменения конфигурации и миграции экземпляров. Инцидент с Heroku в июне показывает, почему неконтролируемые изменения требуют строгого контроля и почему обмен информацией о состоянии должен обладать собственной отказоустойчивостью. Событие 18 июня демонстрирует, почему физическая мощность и зависимость от центров обработки данных по-прежнему важны в облачном сервисе. Декабрьское ухудшение функциональности показывает, почему командам следует отслеживать функции, которые они фактически используют, а не только доступность платформы на самом высоком уровне.
Таким образом, наиболее подходящим ответом является условный. Небольшой организации могут потребоваться уведомления и четкий контрольный список действий вручную. Компании, которая не может приостанавливать продажи или поддержку, необходим независимый мониторинг, восстановление с учетом очереди запросов и отработанный процесс на случай простоя. Организации, работающей в условиях жесткого регулирования, необходимы проверенные методы восстановления, доказательства и управление. Статистика сбоев Salesforce за 2025 год подтверждает один неизменный вывод: отказоустойчивость строится вокруг цепочки зависимостей клиента, а не вокруг одного единственного индикатора «зеленого» статуса.
Источники и сфера применения
В данном ретроспективном обзоре используются записи инцидентов доверия Salesforce и документация Salesforce или Heroku, доступная на момент написания. Страницы инцидентов могут быть обновлены после их разрешения, а информация о покрытии продуктами Salesforce различается между Trust Status и My Trust Center. В тех случаях, когда Salesforce не опубликовала подробный анализ первопричин, в данной статье такой анализ не предполагается.