Ошибка базы данных Nextcloud после обновления: что проверить в первую очередь?
Восстановите доступ к Nextcloud после обновления, диагностировав ошибки SQL, проверив подключение к базе данных и безопасно завершив прерванные миграции.
Для SLES 15 зарегистрируйте расширение SUSE Linux Enterprise High Availability, затем используйте crm cluster initи crm cluster joinдля инициализации узлов. Перед размещением служб в кластере проверьте резервирование сети, защиту узлов (STONITH) и кворум.
Данная процедура соответствует документации SLE HA 15 SP7, актуальной на октябрь 2026 года. Убедитесь в правильности установленного пакета обновлений и архитектуры процессора; идентификаторы регистрации и сведения о поддержке могут различаться.
Используйте как минимум два узла с одной и той же поддерживаемой архитектурой процессора, статические основные IP-адреса, уникальные имена, разрешаемые на каждом узле, и синхронизированные часы с использованием внешнего источника времени. SUSE требует наличия двух резервных каналов связи TCP/IP на каждом узле; имена интерфейсов должны совпадать на всех узлах.
hostname -f
getent hosts node1 node2
chronyc tracking
ip -br addr
Перед началом инициализации выполните проверки на обоих узлах и убедитесь в правильности выбранных интерфейсов и имен.
SLE HA — это отдельно регистрируемое расширение; сам по себе SLES не включает в себя кластерный шаблон. Для зарегистрированных узлов SLES 15 SP7 x86_64 необходимо включить расширение и установить шаблон на каждом узле:
SUSEConnect -p sle-ha/15.7/x86_64 -r ADDITIONAL_REGCODE
zypper install -t pattern ha_sles
Замените ADDITIONAL_REGCODEна свой код подписки. Идентификатор продукта предназначен для архитектуры x86_64; для других архитектур используйте соответствующий идентификатор SUSE. Держите все узлы на одном уровне SLES SP и SLE HA. См. руководство по установке SLE HA 15 SP7 от SUSE .
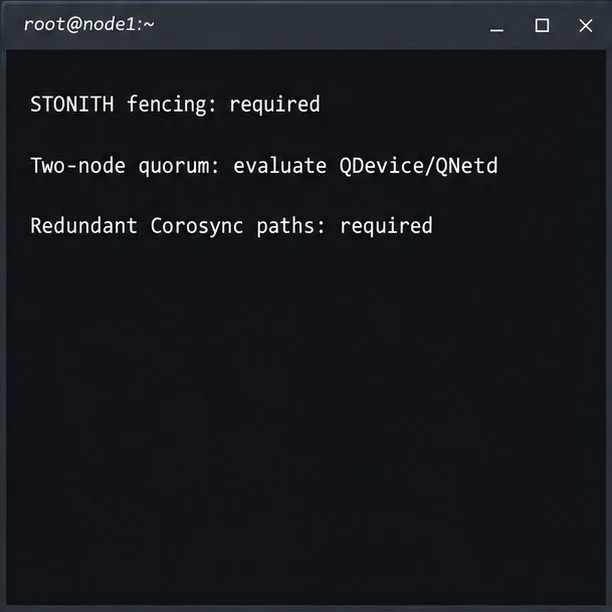
Для поддерживаемых кластеров требуется: изоляция узлов (STONITH), с параметром ` --true` stonith-enabledи ` startup-fencing--left true`. Изоляция изолирует неопределенный узел, чтобы предотвратить запуск одной и той же службы на обеих сторонах раздела. Выберите поддерживаемое устройство управления питанием или SBD с проверенным сторожевым таймером для вашего оборудования или гипервизора.
Для двух узлов: SUSE рекомендует использовать QDevice/QNetd для кластеров с четным числом узлов. Он добавляет независимое голосование за кворум, а не механизм изоляции; если вы включаете QDevice во время начальной загрузки, сначала настройте отдельный сервер QNetd. См. руководство по QDevice и QNetd .
Распространенное заблуждение относительно хранения данных: общее хранилище не является обязательным для каждого кластера, но данные приложений нуждаются в собственном общем, реплицируемом или восстанавливаемом хранилище. Pacemaker перемещает ресурсы, а не копирует данные приложений.
На узле 1 запустите загрузку CRM Shell от имени root или с помощью утвержденной вами учетной записи sudo:
crm cluster init --name prod-haСледуйте подсказкам и выберите нужный адрес Corosync. Скрипт настраивает Corosync, SSH, Csync2, порты межсетевого экрана кластера и Hawk2; он проверяет синхронизацию времени и предлагает опционально SBD и IP-адрес администратора Hawk2. Проверьте /var/log/crmsh/crmsh.logнастройки начальной загрузки.
Перед выбором SBD настройте сторожевой таймер на каждом узле. При использовании внешнего ограждения настройте поддерживаемый им ресурс STONITH перед запуском рабочих нагрузок. Никогда не отключайте STONITH, чтобы обойти отсутствие устройства. Bootstrap создает базовый кластер, а не приложение высокой доступности.
Установите и зарегистрируйте SLE HA на узле 2. Если используете SBD, подготовьте там сторожевой таймер перед подключением. Затем, от имени root:
crm cluster join -c root@node1Для настройки с правами суперпользователя используйте USER@NODE1процедуру SUSE. Укажите те же два интерфейса, если они были настроены при инициализации. Скрипт копирует настройки Corosync, настраивает SSH и Csync2 и переводит узел 2 в онлайн-режим. Повторите для других узлов; не смешивайте методы начальной загрузки и настройки YaST.
Проверьте членство на узле кластера:
crm statusУбедитесь, что оба узла находятся в сети и присутствует кворум. haclusterНачальный пароль инициализируется с помощью функции загрузки linux; измените его на каждом инициализированном узле:
passwd haclusterHawk2 использует HTTPS на порту 7630. Перед тем как доверять самоподписанному сертификату, убедитесь, что он подтвержден вашим администратором. IP-адрес управления Hawk2 не является адресом клиента приложения.
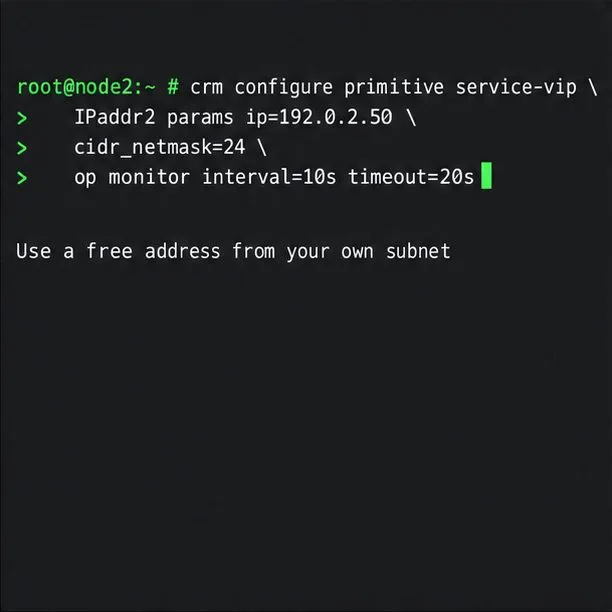
Pacemaker управляет сервисами через агенты ресурсов. Установите и настройте рабочую нагрузку соответствующим образом на подходящих узлах. В этом примере создается только примитив плавающего IP-адреса:
crm configure primitive service-vip IPaddr2 params ip=192.0.2.50 cidr_netmask=24 op monitor interval=10s timeout=20s192.0.2.50Этот раздел предназначен для документации. Замените адрес на свободный и используйте правильный префикс из вашей подсети. IP-примитив не запускает приложение и не реплицирует данные. Добавьте поддерживаемый агент приложения, а также специфические для рабочей нагрузки параметры порядка размещения, размещения и хранения данных; следуйте рекомендациям по восстановлению и изоляции, предоставленным для этого продукта.
После настройки реальных ресурсов и изоляции запланируйте контролируемое тестирование переключения на резервный сервер. Переведите узел 1 в режим ожидания и проверьте работу сервиса с узла 2:
crm node standby node1
crm status
ping -c 4 SERVICE_VIP
crm node online node1
Замените SERVICE_VIPна реальный адрес клиента. Убедитесь, что приложение отвечает, ресурсы перемещаются должным образом, и узел 1 повторно подключается. Пинг проверяет только доступность сети. SUSE crm cluster crash_testнамеренно нарушает работу компонентов, поэтому используйте его в запланированной тестовой среде. Ознакомьтесь с руководством по быстрой установке и настройке SLE HA .
После тестирования убедитесь, что оба узла находятся в ожидаемом состоянии, функция изоляции остается включенной, и рабочая нагрузка отвечает через свою клиентскую конечную точку после того, как узел 1 вернется в онлайн. Зеленый индикатор членства или успешный пинг сами по себе не доказывают восстановление приложения.
Восстановите доступ к Nextcloud после обновления, диагностировав ошибки SQL, проверив подключение к базе данных и безопасно завершив прерванные миграции.
Используйте команду OCC в Nextcloud для сброса пароля администратора из командной строки сервера, с инструкциями по заполнению полей для имен пользователей, разрешений и внешних сервисов авторизации.
Чтобы устранить предупреждение HSTS от Nextcloud, установите заголовок на Apache, NGINX или вашем TLS-прокси, а затем безопасно проверьте публичный HTTPS-ответ.
Причины сбоев при установке приложений из App Store могут быть связаны с DNS, HTTPS, прокси-сервером, TLS или проблемами конфигурации самого сервера Nextcloud.
Перенесите обработку миниатюр в контролируемый фоновый режим, обрежьте неиспользуемые размеры предварительного просмотра и проверьте очередь, не перегружая сервер Nextcloud.
Найдите файл, правило исключения, проблему с подключением или состояние базы данных клиента, препятствующие синхронизации Nextcloud, а затем безопасно проверьте загрузку и скачивание файлов.
Найдите ограничение на использование PHP OPcache, вызывающее предупреждение Nextcloud, обновите правильную конфигурацию PHP для веб-приложений, безопасно перезапустите систему и проверьте результат.
Сравните встроенный и основанный на Docker код, затем подключите Collabora Online к Nextcloud через защищенный обратный прокси-сервер HTTPS.
Спланируйте надежное развертывание Nextcloud HA с использованием общего хранилища, блокировок Redis, маршрутизации MariaDB с учетом кворума и практичных проверок отказоустойчивости.
Настройте и проверьте доступность TURN-ретранслятора для Nextcloud Talk, если брандмауэры или ограничительные NAT блокируют прямые вызовы.


