Главная
» Как сделать
»
В SLES закончилось место в тонком пуле: безопасное расширение LVM и восстановление записей.
В SLES закончилось место в тонком пуле: безопасное расширение LVM и восстановление записей.
Когда тонкопровизионный том SUSE Linux Enterprise Server сообщает об отсутствии свободного места на устройстве, сначала проверьте тонкий пул Data%. Meta%Если область данных заполнена, а в группе томов есть свободные экстенты, расширьте тонкий пул на lvextend— а не просто на виртуальный размер его тонкого логического тома. Полностью заполненная область метаданных — это другое дело: может потребоваться восстановление в автономном режиме, прежде чем возобновится обычная запись.
Описанная ниже процедура использует команды LVM2, описанные для Linux, и модель хранения, описанную в руководстве по администрированию хранилища SUSE Linux Enterprise Server 15 SP7 . Доступность команд и конфигурация служб могут отличаться в других пакетах обновлений SLES или кластерной установке. Перед изменением производственного хранилища создайте резервную копию, обеспечивающую согласованность приложений, и ограничьте интенсивную запись.
1. Проверьте, не исчерпано ли пространство для данных или метаданные.
Выполните следующую команду на хосте, которому принадлежит активный пул тонких дисков, заменив vgdataна имя вашей группы томов:
sudo lvs -a -o lv_name,lv_size,segtype,data_percent,metadata_percent,pool_lv vgdata
Найдите строку, в которой thin-poolпод заголовком SegType« Data%Измеряет выделенные блоки данных; Meta%измеряет метаданные сопоставления пула». Это отдельные ограничения по емкости. Если Data%значение близко к 100, но Meta%значительно ниже, наиболее прямым решением будет добавление дополнительных блоков данных. Если Meta%значение равно 100, используйте меры по восстановлению, описанные в разделе 4.
Пример отображения в терминале: показатель Data% пула близок к полному заполнению, в то время как использование метаданных значительно ниже. Значения иллюстрируют поля для проверки, а не результат диагностики в реальном времени.
В качестве гипотетического примера предположим, vgdata/pool0что размер пула составляет 100 ГиБ, при этом 98,12% используется для данных, а 40,26% — для метаданных. Пул находится под непосредственной угрозой, даже если df -hсообщается о наличии достаточного места внутри смонтированного тонкого тома. Виртуальный размер тонкого тома может превышать физическую емкость пула, как объясняется в документации SUSE Expert Partitioner .
Не следует интерпретировать пустой результат команды grep как доказательство отсутствия неудачных операций записи. Проверьте также журналы приложения, особенно если база данных или виртуальная машина вели запись, когда пул заполнился.
2. Убедитесь, что группа томов имеет свободные физические экстенты.
Прежде чем изменять размер пула, выясните, сможет ли группа компаний профинансировать расширение:
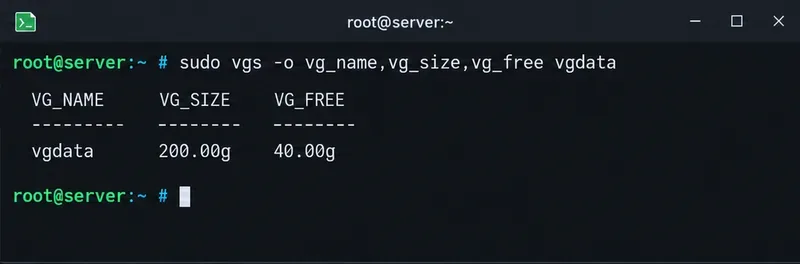
sudo vgs -o vg_name,vg_size,vg_free vgdata
Пример проверки группы томов: VG_FREE указывает, доступны ли физические расширения для увеличения пула pool0 без добавления другого устройства.
В гипотетическом примере группа томов размером 200 ГиБ имеет 40 ГиБ свободного места. Таким образом, расширение пула на 20 ГиБ в принципе возможно, с учетом ограничений по выделению ресурсов и возможности увеличения объема метаданных. Вместо того чтобы выделять все свободные экстенты пулу, лучше сохранить часть пространства группы томов в резерве.
Если VG_FREEзначение равно нулю, lvextendфизическая емкость создать невозможно. Добавьте в группу томов правильно идентифицированный и подготовленный физический том, увеличьте размер базового хранилища и его физического тома LVM, если это необходимо, или освободите блоки перед повторной попыткой. В документации SUSE описано добавление физических томов при изменении размера группы томов . Никогда не запускайте pvcreateоперацию с непроверенным диском: это может уничтожить существующие метаданные хранилища.
3. Расширяйте тонкий бассейн, а не тонкий объем.
Когда Data%ограничивающим фактором является наличие неисчерпаемых метаданных и достаточно свободных областей VG, следует расширить сам пул:
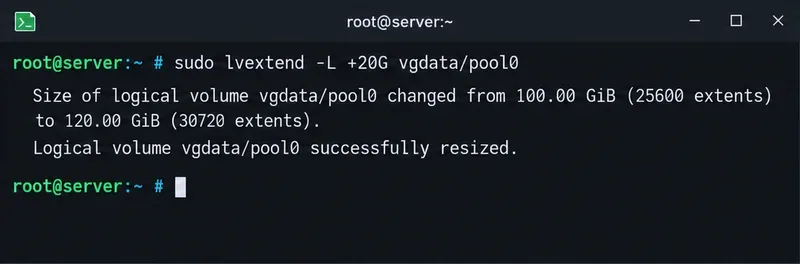
sudo lvextend -L +20G vgdata/pool0
Пример расширения тонкого пула: команда нацелена на vgdata/pool0, а не на тонкий логический том внутри него. Отображаемый ответ является иллюстративным.
Синтаксис +20Gдобавляет 20 ГиБ к текущему размеру пула; он не устанавливает окончательный размер равным 20 ГиБ. В этом примере размер пула увеличивается со 100 ГиБ до 120 ГиБ. При неизмененных выделенных данных 98,12 ГиБ будут использоваться примерно на 81,8% больше увеличенного пула. Фактический процент может отличаться, если во время операции продолжается запись.
Не следует заменять . lvextend -L +20G vgdata/thin1Увеличение виртуального адресного пространства тонкого тома не обязательно добавляет физическую емкость данных в его пул. Поскольку эта команда расширяет пул резервных файлов, а не виртуальное блочное устройство файловой системы, изменение размера файловой системы обычно не требуется для этой конкретной операции. В авторитетном руководстве по тонкому выделению ресурсов LVM описан механизм расширения тонкого пула и его ограничения.
Когда вы не можете сразу расширить бассейн
Если файлы уже были удалены из тонкой файловой системы и функция отбрасывания блоков поддерживается всем стеком, рассмотрите возможность освобождения отброшенных блоков:
sudo fstrim -v /srv/data
Используйте реальную точку монтирования тонкого тома, а не устройства тонкого пула. Успешная операция обрезки может снизить уровень Data%, но удаление только файлов обычно не возвращает блоки в пул. Тонкие снимки могут сохранять общие блоки, и пул, настроенный на игнорирование отброшенных блоков, не получит от этого никакой пользы. Не рассматривайте обрезку как надежную аварийную замену физической емкости, особенно если запись начала давать сбои. Удаляйте старые снимки только после проверки их принадлежности, зависимостей и требований к хранению; удаление снимков необратимо.
4. Рассматривайте заполненную область метаданных как состояние восстановления.
Если Meta%уровень метаданных достиг 100%, остановите запись в приложение и спланируйте контролируемое отключение. LVM предупреждает, что исчерпание метаданных может привести к несогласованности метаданных тонкого пула и файловых систем. Простое увеличение размера данных пула, повторные попытки записи или принудительная активация не устраняют этот риск.
Описанная последовательность восстановления включает в себя деактивацию затронутого пула в автономном режиме, восстановление его ограниченного объема метаданных с помощью lvconvert --repair VG/ThinPool, увеличение объема метаданных с помощью lvextend --poolmetadatasize, а затем проверку каждой затронутой файловой системы с помощью соответствующего автономного инструмента. Например, для пула, объем метаданных которого меньше 2 ГиБ, может потребоваться проверка целевого объекта, такого как:
sudo lvextend --poolmetadatasize 2G vgdata/pool0
Это не команда, которую следует запускать вслепую на активном, поврежденном пуле. Ее размер является примером, а не универсальным требованием. Сначала подтвердите текущий размер метаданных, доступные экстенты, правильность деактивации, носители восстановления и резервные копии. lvconvert --repairПланирование должно осуществляться с учетом времени простоя и наличия специалистов по восстановлению; в руководстве по LVM отмечается, что оно может завершиться неудачей, и данные все равно могут оказаться невосстановимыми. Сохраните старый логический том метаданных до тех пор, пока не будут проверены пул и файловые системы. Резервная копия конфигурации LVM vgcfgbackupне создает резервную копию метаданных тонкого пула. Для критически важных для бизнеса данных обратитесь в службу поддержки SUSE или к вашей команде восстановления хранилища, прежде чем пытаться выполнить восстановление.
5. Включите автоматическое расширение, затем проверьте запись.
После стабилизации системы настройте политику проактивного роста в соответствующем activationразделе /etc/lvm/lvm.conf. В этом примере расширение начинается с 70% использования и запрашивается рост на 20%; настройте следующие значения для скорости записи и доступной емкости VG:
Убедитесь, что настройки применяются к правильной области конфигурации и что пул находится под наблюдением:
sudo lvchange --monitor y vgdata/pool0
Пример команды мониторинга: включение мониторинга событий LVM позволяет автоматически устанавливать политики расширения пула, когда остается достаточно свободных экстентов.
Автоматическое расширение тонкого пула зависит от мониторинга событий LVM ( dmeventd) и достаточного количества свободных экстентов. Проверьте службу мониторинга, предоставляемую вашей установкой SLES — например, systemctl status lvm2-monitorгде находится этот модуль — и просмотрите ее журналы. Пороговое значение не гарантирует защиту, если запись превышает объем экстента или группа томов (VG) уже заполнена. См. руководство по автоматическому расширению и параметры мониторинга lvchange в руководстве LVM .
Убедитесь, что исправление сработало.
Проверили как загрузку пула, так и оставшуюся емкость VG:
Data%После расширения пула данных объем данных должен уменьшиться, Meta%оставаться ниже предела, а пул должен быть активен без новых ошибок ввода-вывода. Проверьте состояние файловой системы и журналы приложений, затем выполните небольшой тест записи и чтения, соответствующий приложению, прежде чем освобождать приостановленные рабочие нагрузки. Если ошибки сохраняются после освобождения места, держите затронутую рабочую нагрузку в автономном режиме до тех пор, пока не будет проверена целостность ее файловой системы и приложения; увеличение емкости не сможет восстановить уже неудачные или потерянные операции записи.