Главная
» Технология
»
Полупроводники следующего поколения: как искусственный интеллект и суперкомпьютеры выходят за рамки миниатюрных транзисторов.
Полупроводники следующего поколения: как искусственный интеллект и суперкомпьютеры выходят за рамки миниатюрных транзисторов.
Короткий ответ: в настоящее время преимущества ИИ достигаются за счет всей полупроводниковой системы.
Аппаратное обеспечение для искусственного интеллекта и суперкомпьютеров следующего поколения создается не благодаря одному прорыву. Оно строится на основе нескольких технологий, которые должны работать вместе: транзисторы с затвором, охватывающим всю поверхность кристалла, подача питания с обратной стороны, чиплетные архитектуры, усовершенствованная упаковка, высокоскоростная память, более быстрые межкристальные каналы связи и все более широкое применение оптических сетей. Практический результат — это увеличение вычислительной мощности, увеличение пропускной способности памяти и лучшая масштабируемость без опоры только на меньшие размеры транзисторов.
Это важно, потому что современные ускорители ИИ и научные суперкомпьютеры часто сталкиваются с ограничениями по перемещению данных и энергопотреблению, прежде чем исчерпают свои вычислительные возможности. Более быстрый матричный движок полезен только в том случае, если веса модели, активации и промежуточные результаты могут достигать его достаточно быстро. Аналогично, добавление большего количества ускорителей полезно только в том случае, если корпус, сетевая стойка, система памяти, система охлаждения и программный стек могут обеспечить их достаточную загрузку.
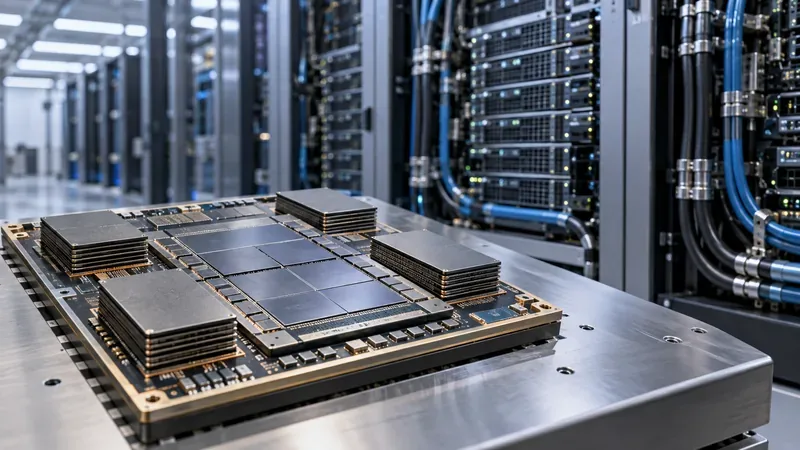
Многочиповый модуль ускорения с несколькими расположенными друг над другом корпусами памяти иллюстрирует направление развития современного аппаратного обеспечения для ИИ: вычислительные ресурсы, память, корпусирование, питание и охлаждение все чаще проектируются как единая система.
1. Новые структуры транзисторов повышают эффективность, но это лишь отправная точка.
Передовые логические схемы отходят от структуры FinFET, которая доминировала в современных микросхемах на протяжении многих лет. В конструкциях с круговым затвором (GAA) затвор обернут вокруг нанолиста или аналогичной канальной структуры, что позволяет разработчикам микросхем осуществлять более жесткий электростатический контроль по мере уменьшения размеров элементов. Это может улучшить производительность, уменьшить утечку или обеспечить лучший баланс между этими двумя параметрами.
Компания TSMC заявляет, что её 2-нанометровый техпроцесс N2 запущен в серийное производство в четвёртом квартале 2025 года, а технология A16 сочетает в себе нанолистовые транзисторы с питанием от задней стороны, ориентированные, в частности, на высокопроизводительные вычислительные устройства с высокой плотностью питания. TSMC сообщила, что серийное производство A16 запланировано на вторую половину 2026 года. См. страницу технологии A16 и годовой отчёт компании за 2025 год .
Intel следует аналогичному направлению с технологией Intel 18A. Ее техпроцесс сочетает в себе транзисторы RibbonFET GAA с системой питания PowerVia на обратной стороне. Intel сообщает, что производство 18A началось в 2025 году, а улучшенная версия 18A-P — в июне 2026 года. Intel также публикует сравнительные данные о производительности, энергопотреблении и плотности для этого техпроцесса; эти показатели предоставлены производителями и должны быть проверены на конкретном проекте, а не рассматриваться как универсальное улучшение на уровне чипа. Актуальная информация доступна на странице техпроцесса Intel 18A .
Питание с обратной стороны имеет важное значение, поскольку в современных микросхемах сигналы и питание должны передаваться по чрезвычайно плотной проводке. Перемещение части сети питания на обратную сторону может высвободить ресурсы маршрутизации на стороне сигналов и улучшить подачу напряжения. Для ускорителей ИИ, где большие массивы вычислительных блоков переключаются с высокой частотой, это может быть так же важно, как и плотность транзисторов.
2. Чиплетные технологии и передовые методы упаковки превращают обычный корпус в небольшую вычислительную систему.
Монолитные кристаллы становятся все сложнее и дороже в масштабировании по мере их роста. Чиплеты предлагают другой путь: отдельные функции могут быть изготовлены с использованием наиболее подходящих для них технологических процессов, а затем соединены внутри одного корпуса. Для вычислительного кристалла может потребоваться самый передовой логический процесс, в то время как для ввода-вывода, кэша, аналоговых схем или других функций это может быть не так.
Практическая ценность заключается в упаковке. Например, передовая платформа упаковки CoWoS от TSMC разработана для интеграции множества логических устройств и стеков высокоскоростной памяти в 2,5D-корпус. TSMC позиционирует CoWoS специально для продуктов в области искусственного интеллекта и высокопроизводительных вычислений, где критически важны короткие и широкие соединения между вычислительными элементами и HBM.
Также появляются стандарты, призванные сделать чиплеты менее проприетарными. Спецификация UCIe 3.0 , выпущенная в августе 2025 года, поддерживает скорости передачи данных 48 ГТ/с и 64 ГТ/с и добавляет функции для повышения энергоэффективности, управляемости и более гибких многочиповых систем. UCIe не сделает чиплеты взаимозаменяемыми в одночасье, но предоставит отрасли общую электрическую и протокольную основу для внутрикристальных соединений.
Этот подход особенно привлекателен, когда компания хочет создать несколько вариантов ускорителей из многократно используемых строительных блоков. Он менее привлекателен, когда стоимость корпуса, тепловая плотность или сложность конструкции перевешивают преимущества модульности. Для более компактного продукта со скромными потребностями в памяти и вводе-выводе может быть предпочтительнее использовать более простое монолитное устройство.
3. Память с высокой пропускной способностью становится столь же стратегически важной, как и сам ускоритель.
В задачах искусственного интеллекта большие тензоры многократно перемещаются между памятью и вычислительными блоками. Это делает пропускную способность памяти первостепенным ограничивающим фактором при проектировании. Высокоскоростная память (HBM) решает эту проблему за счет размещения кристаллов DRAM друг над другом и их физического расположения близко к ускорителю через очень широкий интерфейс.
Технология HBM4 переходит из разряда дорожных карт в коммерческие системы. Samsung объявила о начале коммерческих поставок HBM4 в феврале 2026 года и сообщила о начале массового производства своей продукции с устойчивой скоростью передачи данных 11,7 Гбит/с и возможностью увеличения до 13 Гбит/с. В мае 2026 года Samsung также объявила о начале поставок образцов HBM4E. Эти подробности доступны в объявлении Samsung о начале производства HBM4 .
Компания SK hynix сообщила в своих результатах за второй квартал 2026 года, что начала массовые поставки HBM4 в течение квартала и планирует нарастить производство во второй половине года. Компания также отгрузила образцы 12-слойного HBM4E. Актуальную информацию можно найти в результатах SK hynix за второй квартал 2026 года .
Почему это важно на практике? Текущие спецификации NVIDIA Vera Rubin указывают 288 ГБ памяти HBM4 на одном графическом процессоре Rubin и пропускную способность памяти GPU 19,2 ТБ/с. Для сравнения, ускорители серии MI350 от AMD используют HBM3E; AMD указывает до 288 ГБ и 8 ТБ/с для MI355X. Это разные архитектуры, и их не следует сравнивать только по показателю пропускной способности, но оба примера демонстрируют, что объем памяти и пропускная способность теперь являются основными характеристиками ускорителей, а не второстепенными деталями. См. официальные спецификации NVIDIA Vera Rubin NVL72 и страницу серии AMD Instinct MI350 .
4. Межсоединения, обеспечивающие увеличение и уменьшение масштабируемости, определяют, будут ли многие ускорители работать как один.
Крупные модели и научные симуляции редко умещаются на одном устройстве. Система должна распределять работу между несколькими ускорителями и часто обмениваться частичными результатами. Если связь медленная, дорогостоящие вычислительные блоки простаивают.
Именно поэтому собственные масштабируемые коммутационные сети развиваются параллельно с самими графическими процессорами. Платформа NVIDIA Rubin использует NVLink шестого поколения; NVIDIA заявляет о пропускной способности NVLink в 3 ТБ/с на каждый графический процессор Rubin и 216 ТБ/с в системе NVL72. AMD использует Infinity Fabric на своих платформах ускорителей. Для покупателей важен не только пиковый уровень пропускной способности канала, но и то, как коммутационная сеть ведет себя при выполнении конкретных коллективных операций, параллельных моделей и топологии, используемых приложением.
На уровне системной памяти Compute Express Link также развивается. Консорциум CXL заявляет, что CXL 4.0 удваивает скорость передачи сигналов с 64 ГТ/с до 128 ГТ/с, добавляет объединенные порты и расширяет возможности обеспечения надежности памяти. CXL актуален, когда архитекторам требуется согласованное расширение, объединение или дезагрегация памяти без рассмотрения каждого уровня памяти как удаленного устройства хранения.
5. Кремниевая фотоника приближается к созданию переключающего кремния.
Медь по-прежнему отлично подходит для коротких и плотных электрических соединений, но оптические каналы связи становятся все более привлекательными по мере увеличения расстояния и суммарной пропускной способности. Важным следующим шагом является интегрированная оптика, при которой оптические компоненты перемещаются ближе к сетевой микросхеме ASIC, а не размещаются исключительно в подключаемых трансиверах на границе коммутатора.
Компания NVIDIA заявляет, что её платформа Spectrum-X Ethernet Photonics использует интегрированную оптику и обеспечивает до 5 раз более высокую энергоэффективность сети по сравнению с традиционными конструкциями с подключаемыми трансиверами. Это сравнение с данными от разных производителей, а не гарантия для любой топологии центра обработки данных, но оно подчеркивает направление развития: энергопотребление сети становится настолько важным, что оптическая интеграция теперь является частью проектирования полупроводниковых систем. См. обзор кремниевой фотоники от NVIDIA .
Что это означает для реальных задач искусственного интеллекта и суперкомпьютерных вычислений?
Емкость и пропускная способность HBM, быстрое масштабирование каналов связи, компактная компоновка, эффективное охлаждение.
В процессе обучения большое внимание уделяется перемещению тензоров и синхронизированной связи между множеством ускорителей.
Длинный контекст и вывод о субъектности
Большие пулы HBM, эффективные вычисления с низкой точностью, высокая пропускная способность межсоединений, многоуровневое хранение памяти.
Кэширование ключ-значение и повторяющиеся шаги рассуждений могут сделать объем памяти и перемещение данных более ограничивающими, чем пиковые значения FLOPS.
Научные высокопроизводительные вычисления
Поддержка формата FP64, пропускная способность памяти, надежные межсоединения, развитые численные библиотеки.
В программном обеспечении для моделирования часто используются методы двойной точности и постоянной пропускной способности, а не только обработка тензоров с низкой точностью.
Вывод предприятия
Производительность на ватт, совместимость с программным обеспечением, оптимальный объем памяти, варианты развертывания PCIe.
Наилучшей системой может оказаться та, которая подходит для существующих серверов и соответствует требованиям к электропитанию, а не самая компактная стоечная архитектура.
Пользовательские ускорители
Стратегия чиплетирования, экосистема упаковки, поддержка UCIe, зрелость процесса.
Модульная конструкция может сократить циклы повторного использования, но сложность упаковки и требования к квалификации поставщиков могут нивелировать это преимущество.
Конкретный пример: почему более быстрой видеокарты недостаточно.
Рассмотрим команду, работающую с большой языковой моделью с длинными контекстными окнами. Предположим, профилирование показывает, что графические процессоры часто ожидают передачи данных в память и межпроцессорной связи. Переход на более новый ускоритель может помочь, но только если новая система также обеспечивает достаточную емкость HBM, более высокую пропускную способность памяти и топологию, которая уменьшает задержки связи. Приобретение устройства с большей теоретической производительностью тензоров при сохранении тех же узких мест в памяти и сети может дать гораздо меньше улучшений, чем предполагает заявленная спецификация.
Тот же принцип применяется и в традиционных суперкомпьютерах. Система Frontier Национальной лаборатории Ок-Ридж сочетает в себе ускорители AMD MI250X с HBM и высокоскоростным системным межсоединением. В руководстве пользователя Frontier описано, как взаимодействуют вычислительные ресурсы, HBM, каналы связи CPU-GPU и сеть Slingshot. Аппаратное обеспечение этого поколения старше новейших платформ ИИ 2026 года, но архитектурный урок по-прежнему актуален: стабильная производительность приложений зависит от пути между вычислительными ресурсами, памятью и другими узлами.
Когда стоит обновлять полупроводниковое оборудование следующего поколения?
Обновление наиболее оправдано, когда оно устраняет выявленное узкое место, а не просто заменяет деталь с более старым номером. Прежде чем принимать решение о переходе на новое поколение ускорителей, проверьте следующее:
Нехватка памяти: Выполняется ли выгрузка данных из модели или симуляции в память хоста, требует ли агрессивного создания контрольных точек или вынуждает к неудобному разделению модели на разделы?
Давление на пропускную способность: Ограничены ли ядра памятью при профилировании, или же ускорители тратят значительное время на ожидание завершения операций all-reduce и других коллективных операций?
Электропитание и охлаждение: сможет ли стойка, помещение и контур охлаждения обеспечить необходимую плотность мощности? Более высокая производительность может оказаться нецелесообразной, если модернизация инфраструктуры будет преобладать над затратами.
Готовность программного обеспечения: соответствуют ли компилятор, библиотеки, ядра, стек оркестрации и инструменты мониторинга требованиям новой архитектуры?
Требования к точности: Может ли рабочая нагрузка безопасно использовать форматы с более низкой точностью, или же требуется формат FP64 или другой формат с более высокой точностью?
Использование: Будет ли нагрузка достаточной, чтобы оправдать стоимость нового оборудования? Производственные мощности, простаивающие без дела, не становятся экономически выгодными только потому, что чип новее.
Компромиссы становятся все более физическими.
Прогресс в полупроводниковой отрасли приводит к впечатляющим результатам, но ограничивающие факторы становятся все более ощутимыми. Усовершенствованные корпуса становятся больше и сложнее в производстве. Стеки HBM концентрируют тепло вблизи мощных логических элементов. Системы стоечного масштаба могут потребовать жидкостного охлаждения, плотного распределения питания и специализированных сетевых решений. Совместная упаковка оптики может снизить энергопотребление сети, но при этом вносит новые аспекты в производство и обслуживание. Чиплеты могут повысить модульность, но добавляют работы по валидации, упаковке и управлению выходом годных изделий.
Существует также компромисс в программном обеспечении. Арифметика низкой точности, такая как FP8, FP6 или FP4, может значительно повысить производительность ИИ, но программное обеспечение должно сохранять качество модели. Научные коды могут не иметь возможности использовать те же самые упрощенные методы. Полупроводниковая функция ценна только тогда, когда стек приложений может использовать ее, не нарушая требований к точности или надежности.
Что посмотреть дальше
В оставшейся части 2026 года и в 2027 году наиболее полезными сигналами будут не только новые названия технологических узлов. Следует следить за тем, как технологические процессы TSMC A16 и Intel 18A будут внедряться в широкий спектр продукции для клиентов; как быстро HBM4 и HBM4E станут доступны в больших масштабах; обеспечит ли UCIe 3.0 значимую совместимость чиплетов разных производителей; где CXL 4.0 появится в производственных системах; и окажется ли совместно упакованная оптика экономически выгодной и пригодной для использования в больших масштабах развертывания.
Эти достижения покажут, сможет ли полупроводниковая промышленность продолжать масштабировать ИИ и суперкомпьютеры, не допуская, чтобы перемещение памяти, электропитание, сети и охлаждение нивелировали преимущества, достигнутые за счет более плотной логики.
Итог
Будущее искусственного интеллекта и суперкомпьютеров определяется не столько одним «следующим узлом», сколько скоординированной разработкой полупроводниковых компонентов. Транзисторы GAA и питание с обратной стороны улучшают логическую основу. Чиплеты и передовые технологии упаковки позволяют разработчикам создавать системы большего размера, чем те, которые можно комфортно обеспечить с помощью одного кристалла. HBM4 обеспечивает работу ускорителей на экстремально высокой пропускной способности. UCIe, CXL, NVLink, Infinity Fabric и оптические сети передают данные во все более крупных областях.
При выборе оборудования начните с реального узкого места вашей рабочей нагрузки. Для ИИ, работающего с большими объемами памяти, отдайте приоритет емкости и пропускной способности HBM. Для распределенного обучения отдайте приоритет масштабируемой и расширяемой архитектуре. Для научных вычислений проверьте производительность FP64 и библиотек. При корпоративном развертывании учитывайте энергопотребление, охлаждение, программную поддержку и затраты на интеграцию. Самый быстрый полупроводник на бумаге не обязательно является самым быстрым или экономичным решением для вашей рабочей нагрузки.